Misskeyのノート検索をpg_bigmで爆速化する
Misskeyのノート検索は、Misskey単体だとPostgreSQL上でLIKE演算子による全文部分一致検索という大変重たい方式になっており、ある程度の大規模サーバーになるとタイムアウトして動かなくなります。そこで高速全文検索のために外部サービスとして昔はelasticsearch、最近*1はmeilisearchといったインデックスサービスを別立てして利用できるようになっています。
最近ですと、インデックスサービスを別に立てるのはやはり運用上も大変ということで、別サービスを立てるのではなくpgroongaをPostgreSQLに組み込んで全文検索させるという手法も広がってきています。ただpgroongaはpgroongaで、運用的には楽でも導入が大変。なにしろ独自定義のSQL演算子を使って全文検索をリクエストしないといけないのでMisskey本体のプログラムを改変する必要があります。そしてその改変版は、pgroongaの入っていないPostgreSQLでは動きません。
この痛しかゆしな状況、解消できるソフトウェアがあります。PostgreSQL用の全文検索拡張としてはわりと古株、NTT DATA生まれのOSSのpg_bigmというのがそれです。
- 日本語にも対応している(PostgreSQLに標準添付されている全文検索拡張のpg_trgmは日本語に非対応なのです)
- LIKE '%検索ワード%' 式で使える。つまりMisskey側を専用版に改変する必要がない
この2条件を満たしているので導入も運用も比較的楽だってわけです。私の運営しているサーバーの https://reax.work/ 「リアクションするだけのお仕事」ではこのpg_bigmを組み込んで高速検索を実現できました。そこで、導入方法についてまとめておこうと思います。
全体像
- Misskey本体の微修正
- PostgreSQLへのpg_bigm導入
- pg_bigm有効化と、インデックス作成
1. Misskey本体の微修正
Misskey本体の専用版化なしで、という風に冒頭で書いたわけですが、実は素のMisskey 2024.11.0 ですとpg_bigmは使えませんでした。それは、このバージョンまではLIKE演算子と言っても厳密には大小文字を同一視するILIKE演算子を使っており、pg_bigmはILIKE演算子では動かないからです。
ただ、LIKE演算子でも大小文字を同一視した全文検索は書けますよね。こう書くだけです。
LOWER(note.text) LIKE '%小文字化した検索ワード%'
そして、ちょっと意外なことになのですがこのように書き換えた場合、素のPostgreSQLでも検索パフォーマンスは条件次第だがやや向上するのだそうです。SO諸賢いわく。 performance - LOWER LIKE vs iLIKE - Stack Overflow
というわけで、pg_bigmを使いたい人にもそうでない人にも損じゃないこの変更、Misskey本家へのプルリクにしておりまして、本日ありがたくもマージしていただきました。 https://github.com/misskey-dev/misskey/pull/15205
そういうわけで2024.11.0の次のバージョンのMisskeyからですと無改変でpg_bigmが使えるというわけになるのですが、そのリリースを待てないという方ですとか、あとはMisskeyフォークを使っているのでいつ取り込まれるかわからないという方のために取り込み用のブランチを用意いたしました。
cherry-pickしていただいてもいいですし、あと分岐元を相当古く(13.12.0)しておいたので、大方のフォークでしたら単にmergeするだけでこの変更だけ取り込めます。
$ git remote add yuba-misskey https://github.com/yuba/misskey.git
$ git fetch yuba-misskey
$ git merge yuba-misskey/feature/like-lower
あとは、2024.11.0にこの修正だけ入れたバージョンのDockerイメージも公開しております。
2. PostgreSQLへのpg_bigm導入
まず、pg_bigmはクラウドDBの二大巨頭、Amazon AuroraとGoogle Cloud SQLでは最初からインストール済みです。ですのでこのステップはいきなりスキップです。うれしいですね。
さてオンプレ派。拡張は、PostgreSQLのextensionディレクトリとlibディレクトリに所定のファイルを置き、postgresql.confに shared_preload_libraries='pg_bigm' と書き込むことでインストールできます。さてその所定のファイルを用意する方法なのですが、pg_bigm本家では2通りの方法を用意しています。
- tar.gzを展開してmake && make install
- rpmパッケージ
前者は「所定の位置」を自力で検知して成果物の配置までしてくれます。具体的には、pg_configコマンドにPATHが通っていればそれを呼び出すことで、通っていなければPG_CONFIG環境変数でpg_configコマンドのフルパスを教えてもらうことでpg_config経由でディレクトリ構成を勝手に取得してくれるという仕組み。
DockerfileでPG15向けに書くとこんな感じになります。
FROM postgres:15

RUN apt update
RUN apt install -y curl make gcc postgresql-server-dev-15

RUN curl https://github.com/pgbigm/pg_bigm/archive/refs/tags/v1.2-20240606.tar.gz -L -o pg_bigm.tar.gz  # -L は301リダイレクト対応の指示
RUN tar zxf pg_bigm.tar.gz
RUN cd pg_bigm-1.2-20240606 && make USE_PGXS=1 && make USE_PGXS=1 install

RUN echo shared_preload_libraries='pg_bigm' >> /etc/postgresql/postgresql.conf
rpmパッケージを使った場合はこの配置先自動検知まではやってくれず、とりあえずで /usr/pgsql-15/ なるディレクトリに置かれてしまいます。そこから先は自力でコピーすることになります。これもDockerfileで書くとこんな感じに。
FROM postgres:15 AS pg_bigm

RUN apt update
RUN apt install -y curl alien

RUN curl https://github.com/pgbigm/pg_bigm/releases/download/v1.2-20240606/pg_bigm-1.2.20240606-1.pg15.el9.x86_64.rpm -L -o pg_bigm.rpm
RUN alien -i pg_bigm.rpm


FROM postgres:15

COPY --from=pg_bigm /usr/pgsql-15/share/extension/* /usr/share/postgresql/15/extension/
COPY --from=pg_bigm /usr/pgsql-15/lib/* /usr/lib/postgresql/15/lib

RUN echo shared_preload_libraries='pg_bigm' >> /etc/postgresql/postgresql.conf
docker使わずPostgreSQL動かしている皆様も、これらのコマンド列見ていただければだいたいインストールに必要な操作はわかるのではと思います。インストールが終わったらPostgreSQLは再起動してください。ここでどうしてもサービス中断が発生しますね。バックアップを取ることも含めてメンテナンス計画を立ててやっていきましょう。
3. pg_bigm有効化と、インデックス作成
CREATE EXTENSION pg_bigm SCHEMA public;
コマンドでpg_bigmは有効化できます。ここで、CREATE EXTENSIONコマンドはデータベースのスキーマ単位を対象にしています。SCHEMA public と指定したとおりカレントデータベースのpublicスキーマに魔法がかかりますので、Misskeyの使うデータベースをカレントデータベースにした状態でこのコマンドを打ってください。
そしてここからがキモのインデックスの作成です。
noteテーブルのtextカラムを検索対象にしたいのですが、note.text に対してインデックスを張るんではいけません。LIKEで大小文字同一視検索する話のところで出てきましたが、LIKEで検索する対象は LOWER(note.text) なのです。だからLOWER(note.text)に対してインデックスを張ります。
CREATE INDEX CONCURRENTLY note_lower_text_bigm ON note USING GIN(LOWER(text) gin_bigm_ops);
インデックスを作成しろという命令なのですが、ちょっと解説しておきますと、
- CONCURRENTLY ⋯ テーブルロックをかけるなという意味。インデックス作成には長時間かかる(700万ノートで4分強かかりました)ので、何も指定しないとテーブルロックがかかりこの間Misskeyサービスはほぼ無応答になってしまいます。それを避けるための指定です。当然、インデックス作成にさらに時間がかかるというデメリットもあるはずなのですが、noteテーブルの行の大部分は更新のかからない古い行ですので実際には体感できるほどの時間差は付きませんでした。
- USING GIN ⋯ 浅い理解しかしていないのですが、転置インデックスを実装するためのインターフェースってことになるんですかね、GIN。インデックス方式としてGINを使え、それに実際に使わせる実装(「演算子クラス」と呼ぶよう)にはgin_bigm_opsを使えと指示しています。gin_bigm_opsは、CREATE EXTENSION命令によって組み込まれたもの。
実際に動くところを見てみましょう
ここまででpg_bigmによる高速検索はもう動く状態になっています。実際に動くところを見てみましょう。
この通り、検索しはじめも追加ロードもほとんど待たされずに出てくるようになっています。
ディスク容量ですが、導入前はDB全体で7.2GBだったのが導入後7.3GBと微増にとどまっています。メモリ使用は導入前後とも4GB強で目に見える変化はありませんでした。
まとめ
pg_bigmは導入も運用も楽でサーバーリソースへの負荷も軽いという、どなたにもおすすめしやすい全文検索ソフトウェアです。meilisearchがいいかpgroongaがいいかというMisskey鯖缶界での論争を終わらせてくれる最終兵器と言えるのではないかなと思っております。お試しください。
*1:2023年前半、13.12あたりから
Misskeyのフォントをいい感じにいじっちゃう
りんごぱい Advent Calendar 2024 の記事です。微妙すぎてわからない頑張りの話をします。
MisskeyがMacでばっかり可愛い問題
Misskey楽しいですよね。なにより雰囲気がいい。
この雰囲気がどこから来ているかというと、人々が良いしシステムも良いしルック&フィールも良いんですが、そのルック&フィールの中でもフォントが良いと思いませんか。⋯思いませんか。あ、その前にどんなマシンからMisskeyを見ていますか?
MacやiPhone, iPadから見ている人は、フォントが良いというのちょっとわかってもらえると思うんですよね。だってこれですよ。

ヒラギノ丸ゴシックPro。ゆったりした柔らかさ可愛さとかっちりとした姿勢の良さが同居した見てるだけで楽しくなるフォント。
買えば普通に2万円オーバーなのでWindowsの人はデザインのお仕事じゃないとまず持っていないと思うのですが、MacとiPhoneはこれが標準で入っているんですよね。それで、
Hiragino Maru Gothic Pro, BIZ UDGothic, Roboto, HelveticaNeue, Arial, sans-serif
とフォントファミリーの先頭に指定されているヒラギノ丸ゴで表示されてくれて、楽しいMisskeyライフが彩られます。
さてWindows。あとLinuxとかAndroidとか。
いまどきのWindowsだと、2番手指定のBIZ UDゴシックがありますからこうなります。

ああー、はい。UDなのは良いですよね。刺激が少なく読みやすいし、小さな画面でも読めるところは視覚特性関係なく誰にもうれしいですよね。
ただヒラギノ丸ゴのゆったりさ可愛さがあるかというと、それはないんじゃないかと思うんですよね。あと英数字が固定幅になっちゃってるのもやや雰囲気とずれてます。それで最初に、MacとiPhoneの人に限定してMisskeyのフォントも魅力と思うんじゃないですかって言いました。
Ubuntuなんかだとこうなります。日本語は最後のsans-serifまでフォールバックして、実フォントはNoto sansですね。

Noto sansもクセがなくて悪くないフォントなんですよ。”標準”の字体をどストレートに取りに来ましたって感じで。英数字もいい感じですし。
悪くないです。というか良いです。ヒラギノ丸ゴを体験してしまわなければ。
ギリシャ文字とキリル文字はMacでもいけてない問題
ギリシャ文字とキリル文字、ああーはいはいって感じですね。そう、こうなります。

世界中のどの文字もいまどきのコンピューターならなんかまともな感じに表示してくれるのに、ギリシャ文字とキリル文字だけは不格好な全角表示になってしまう。これはヒラギノ丸ゴでも、BIZ UDゴシックでもです。ましてUI表示言語をロシア語とかに設定したときの悲惨さはこれですからね。

誰が悪い⋯ とは決められないんですが、JIS第一水準漢字セットに入っちゃったこと、Unicodeにマッピングするときに欧文文字セットのギリシャ文字・キリル文字と同じ文字に割り当てられちゃったこと⋯なんですかね。(個人的には、JIS第一水準漢字の全角アルファベットは欧文のアルファベットと別文字とされたんだから同じ扱いで全角半角形に置いてくれれば問題なかったんだよなと思ってますけどね)
というわけで【Mac/iPhone以外でフォントが可愛くない】【ギリシャ文字・キリル文字が全角表示で不格好】これがMisskeyのフォントでどうにかしたいと思っているところになります。
Mac以外でもヒラギノ丸ゴっぽいフォントを表示させてみよう
表示させようったってWindowsに入っていないフォントは表示させようがない⋯ことはないんですよね。Webフォントを使えば。もっと具体的にはGoogleフォントを使えば。Googleフォントを使うと、インターネット上のフォントファイルをCSSから取り込んで使えます。
Googleフォントからゆったりして可愛くてそれでいて姿勢も良い日本語フォントを探したんですけどね、あった、ありましたよ、これ、どうです!? Kosugi Maruフォント。

この立ち姿、そもそも丸ゴシックだし、ヒラギノ丸ゴに相当近いんじゃありませんこと!? 英数字が固定幅なところがちょっと希望と違いますが、それのことはまたあとで考えることにして、では、これをMisskeyに組み込んでみます。組み込むのは簡単。【設定】【全般】画面の一番下、【カスタムCSS】のところに次のように書くだけです。
@import url('https://fonts.googleapis.com/css2?family=Kosugi+Maru&display=swap');

html {
  font-family: Hiragino Maru Gothic Pro, Kosugi Maru, BIZ UDGothic, Roboto, HelveticaNeue, Arial, sans-serif
}
1行目のimportというのが、Googleフォントを取り込む指定ですね。この書き方は、Googleフォントのページから取得できます。
そして、フォントファミリー指定の2番目にKosugi Maruを割り込ませてみました。あくまでヒラギノ丸ゴがあればやっぱりそっち優先って⋯
さてさて、それではWindowsでどうなったか。

WindowsのClearTypeレンダリングがクセ強めなのとディスプレイがRetinaみたいな高精細じゃないのとではっきりしてませんが、拡大してみるとあの日Macで見たMisskeyの面影がかなり具現化してるのがわかります。やったね。

英数字が固定幅なのとギリシャ文字・キリル文字問題にまとめて斬りかかる
さあKosugi Maruは英数字が固定幅でした。上のスクショでもそれがわかりますね。それとギリシャ文字・キリル文字問題をまとめて退治しようってんですが、それはこういうことです。
●いい感じの欧文フォント(ギリシャ文字・キリル文字も含んでるやつ)を一個高い優先順位に入れる
これです。英数字・ギリシャ文字・キリル文字だったらその「いい感じの欧文フォント」で表示され、それ以外の文字、まずは日本語ですね、それらはフォールバックして後続のヒラギノ丸ゴなりKosugi Maruなりで表示してくれるようにするってわけです。
それでまたGoogleフォントを漁りました。いい感じのフォントはないかって。
⋯なかった⋯
1400個だかのフォントがあるGoogleフォント、もちろん良いフォントだらけなんですが、ヒラギノ丸ゴと雰囲気が合うやつというと、見当たらなかったんすよ⋯
でも大丈夫。欧文フォントならPC標準搭載のやつも候補に上がってきます。WindowsとMacの両方で標準搭載しているようなフォントでいいのがあれば⋯ あった! Verdanaです。
Verdanaは丸ゴシックではなく角ゴシックになるのですが、ゆったりしたリラックス感とかっちりした姿勢の良さを両立しているって点で雰囲気はぴったりあっています。
さっそくやってみましょう。フォントファミリーの列の頭にVerdanaを入れて
@import url('https://fonts.googleapis.com/css2?family=Kosugi+Maru&display=swap');

html {
  font-family: Verdana, Hiragino Maru Gothic Pro, Kosugi Maru, BIZ UDGothic, Roboto, HelveticaNeue, Arial, sans-serif
}
はい!

あ、雰囲気いい。


ロシア語UIにしたところも見ておきます?

やーよかったよかった。
これユーザーごとの設定でなくて標準にできなくて?
カスタムCSSって、ユーザー設定にしかなくてコントロールパネルにはないから、鯖缶がサーバー全体にカスタムCSSをかけるってことができないんですよね。やるとしたら、Misskeyのコードを書き換えないとって話になります。
といっても、ここにカスタムCSSと同じように書き加えるだけで終わりじゃないかな⋯.
https://github.com/misskey-dev/misskey/blob/e8bf6285/packages/frontend/src/style.scss#L36
そしてサーバーごとにカスタマイズしなくてもいいように、Misskeyの本流にその修正をプルリクしませんかみたいな話にもなるかもしれないんですが、どうでしょうね。
Misskeyの開発陣の間では、Googleフォントみたいな外部のリソースに実行時依存を持つことは必ずしも総意を得られるわけではないことのよう 参考 。
それはそうって思いますね。
ただそれと同時に私の考えはまた少し違っているところもあって、これみたいな「なくても問題ないし、あったらより良くなる」タイプの外部リソース依存はそんなに忌避しなくていいんではないかなって。
うちの母艦の https://reax.work/ でCSS改修うまい感じに動いたら、どこからでも取り込めるようブランチ公開しますね。
SQLの文法がこう拡張されるとうれしい
SQLを書いていていろんな場面で「こんな文法であってくれたら!」と歯がゆい思いをすることは多々あります。
これまでに、こう拡張されてくれたらと思った内容をまとめてみました。
なお、この拡張は各社DBの“方言”とはまた別のものです。各社方言とは直交した拡張です。
また、純粋なテキスト変換処理で現行のSQLに変換できるようにというのも意図しています。
dangling comma, その他,
カンマ区切りでカラムを列挙するときに、リストの最初と最後に無意味なカンマを許します。
SELECT
  col1,
  col2,  -- ← これがdangling comma
FROM
  some_table
こういう書き方が許されるというもの。カラム構成を編集するときにコピペ操作がしやすくなります。また、gitの変更履歴が見やすくなります。
SELECT, ORDER BY, GROUP BYなどのカラム定義リストのほか、IN句の値リスト、関数呼び出しの引数リスト、WITH句のCTEリストも対象です。
カンマのほか、AND, OR, UNION [ALL], INTERSECT [ALL] についても同様の扱いをします。
空のWHERE, その他
WHERE, HAVING, ON句に何も条件式を書かないことを許します。
これは、句ごと省略されたものと解釈されます。
字句解析がちょっと面倒なことになるので、()は書いてもらうことにしましょう。
すると、
SELECT *
FROM some_table
WHERE (
    ${conditions}
)
のように動的に絞込条件を組み上げる際に、conditionsが空であれば
SELECT *
FROM some_table
だと解釈してもらえるということです。
ここでいう動的な組み上げというのは必ずしもSQLインジェクション脆弱性を生む組み上げ操作というわけではありません。
プリペアドステートメントを組み上げるような場合とお考えいただければ。
空のIN句
col1 IN ()
という書き方を許し、この式は常にFALSEとなるというもの。左辺がNULLであってもFALSE。
もちろん目的は動的なIN句の生成に空リストを渡せるように。
IN, ANY, SOME, ALL(テーブル)
ある値が指定テーブル内に見つかるかを調べるとき
col1 IN (SELECT col2 FROM other_table)
と書くわけですが、other_tableに1カラムしかないことがわかっているのなら
col1 IN (SELECT * from other_table)
でもOKです。 これを
col1 IN other_table
と書いても良いという拡張。特にother_tableがCTEである場合に使いやすいです。1カラムしかないことはこのSQL内で保証できますからね。
EXISTS(テーブル)
上記とほぼ同様。
EXISTS(SELECT 1 FROM some_table)
を
EXISTS some_table
と書かせてくれよという拡張。
クロスIN
それマルチカラムアトリビュートやってるのを解消すべきじゃないのと怒られることが多そうではありそうですが
(col1 IN (v1, v2, v3) OR col2 IN (v1, v2, v3))
みたいな式を
SOME col1, col2 IN (v1, v2, v3)

-- または

ANY col1, col2 IN (v1, v2, v3)
と書けるようにという拡張。 同様に、
ALL col1, col2 IN (v1, v2, v3)
は
(col1 IN (v1, v2, v3) AND col2 IN (v1, v2, v3))
と解釈されます。
JOIN USING, JOIN ON
結合条件はSQLだと
table1 JOIN table2 ON 結合条件

-- または

table1 JOIN table2 USING (結合カラム)
と指定するものですが、次のように書けた方が編集しやすいです。
table1 JOIN ON (結合条件) table2

-- または

table1 JOIN USING (結合カラム) table2
だって、結合段数が多いとき、
FROM
  users u
    JOIN USING(user_id)
  blog b
    JOIN USING(blog_id)
  articles a
    JOIN ON(a.article_id = c.article_id)
  comments c
となりますから、行単位で入れ替えをしても式を壊してしまいにくくなりますし見通しも良くなります。
ON句の末尾の判定が難しくなるので、ON句の条件部分を括弧でくくるのは必須になりますね。
(現行のSQLでもON句の条件部分を括弧でくくるのは良い書き方だと思います)
FROM 〜 TO 〜
BETWEEN 〜 AND 〜演算子の使い勝手、悪いと思いません?
「A以上B以下」なので時刻指定の問い合わせでよく使う「A以上B未満」に使えないのです。
そこでFROM 〜 TO 〜演算子。条件式を書くコンテキストに限っては
x FROM a TO b
が
(a <= x AND x < b)
と解釈されます。
「条件式を書くコンテキスト」ってのが微妙なんですけどね。 PostgreSQLみたいにbool型があって条件式とbool型の計算式の区別がないDBにとっては、WHERE句内とかCASE WHEN句内ではこのFROM-TOが書けるのにSELECT句内でbool型の計算式を書いているときにはFROM-TOが使えませんってなって統一性を欠くことに。
SELECT句を最後に書ける
SELECTがクエリの最初に来るの、ほんとおかしくありません?
だって、クエリを頭から読んでいってまずカラム名のリストを読まされるんだけど何のテーブルだか分からないからそれがカラム名であるかさえよくわからないし型も当然わからない。
先を読まないと意味が確定しない記述なんてプログラミング言語として最低です。
そのくせORDER BY句とかGROUP BY句では、SELECT句で定義して命名したカラムが使えないんですよ。すでに定義が明かなキーワードが逆に使ってもらえないという本末転倒ぶり。
SELECT句が最後に来ればすべてはすっきりするのです。(CTEのことはおいておいて)FROMから書き始め、最後の最後、GROUP BYよりもORDER BYよりもHAVINGよりもLIMITよりも後にSELECTが来る。
そう書かせてくださいよと。おっとそれどこのLINQ。
第4回Kotlin勉強会 @ Sansanにいってきた
AltJava言語(特に手続き型のBetter Java言語)では3年前からCeylon推しだったんですが、Kotlinにはかなわなかったなーと負けを認めてKotlin勉強会に参加してきました。 ちなみに同時期、AltJS言語としてHaxeを推してたけどこれもその後の流れはTypeScriptの完全勝利っぽくて自分の目利きのできなさにウケるんですけど、CeylonとHaxeがこれまた雰囲気似てる言語で苦笑するしかないです。
Sansanさんのオフィスかっこいい
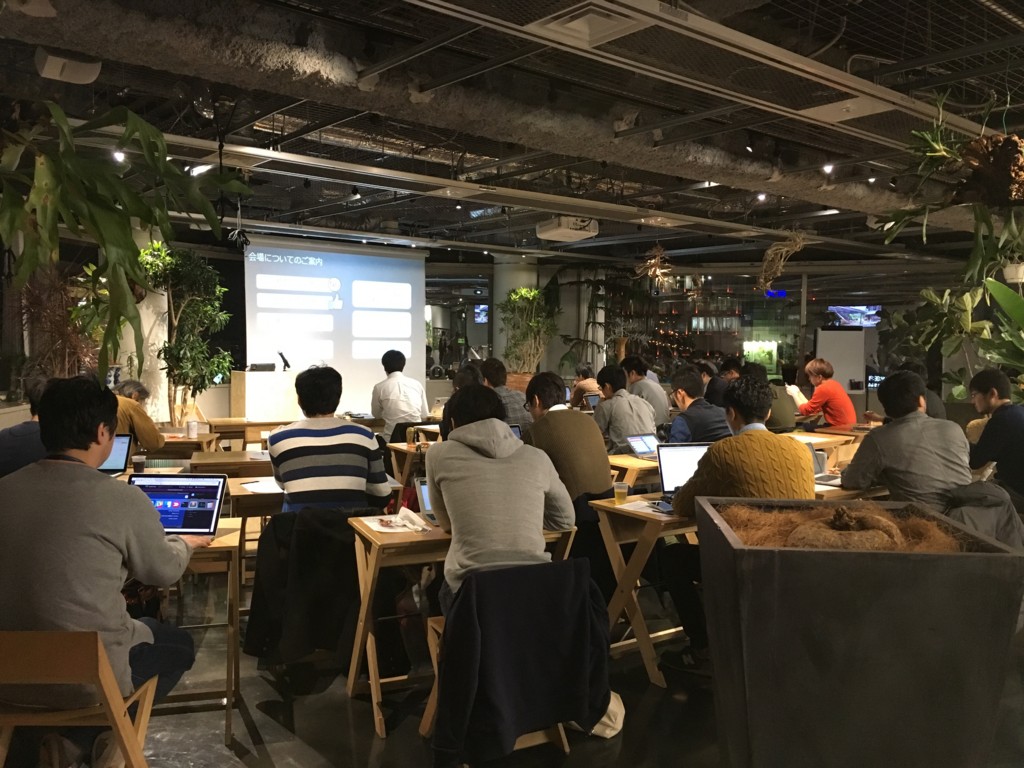 同じく渋谷宮益坂のビズリーチさんところも渋谷Javaで何度かお邪魔していますが、あそこもオフィスかっこいいし、渋谷すごいですね(小並
乾杯で勉強会スタートだ
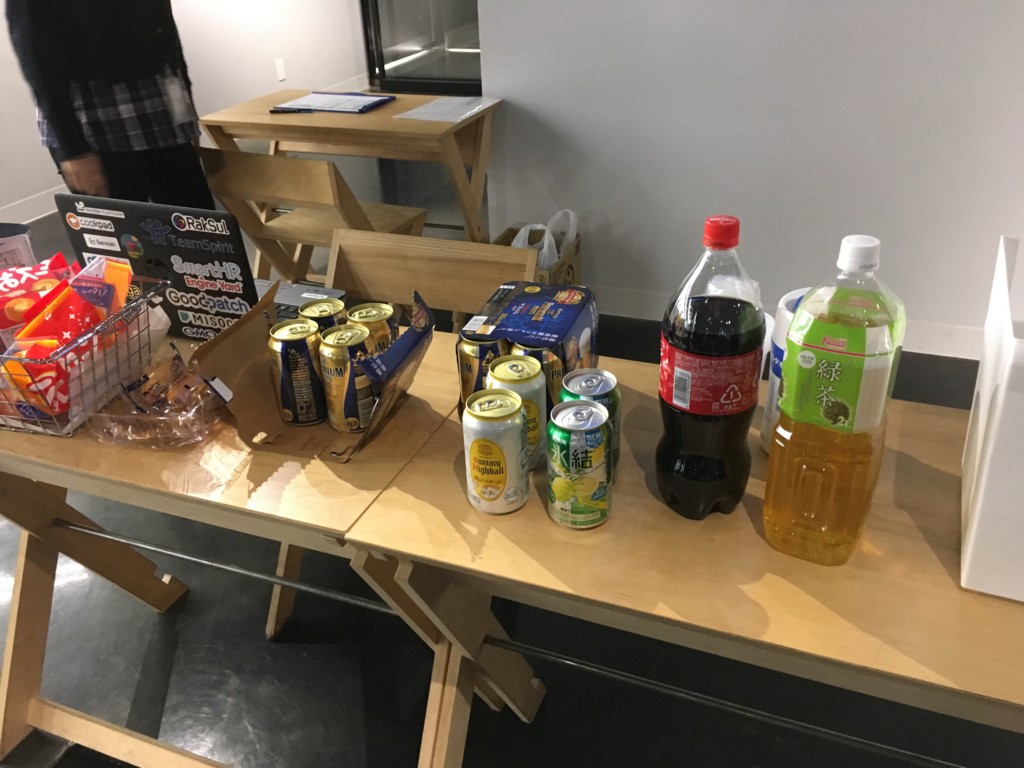 メインゲストのたろうさんのご意向もあって🍺片手の勉強会となっていました。懇親会じゃなくて本体が乾杯で始める勉強会って初めて。Sansanさんごちそうさまでした。
KotlinでDSLを組む話
Sansanの山本さん(@boohbah)の発表。「KotlinでDSL」
DSLを作る話、ここでは自力でインタープリタを作る“外部DSL”ではなく、ホスト言語機能を応用してDSLを実現する“内部DSL”を作ろうという話です。Kotlinの豊富な糖衣構文機能は、こう言われてみるとまるでDSLを組むために用意されてきたのか、という気がしてきます。
使っている機能は
- 拡張関数 - 既存のクラスにメソッドを生やす。C#でいう拡張メソッド。
- invoke - この名前のメソッドを用意しておくと () 演算子で呼び出せる。C++でいう operator()。
- ()の省略 - 引数がラムダ式ひとつの場合は関数呼び出しの () を省略できる。
- レシーバ付き関数リテラル - ラムダ式の仲間なんだけど、ドット記法で呼び出すので拡張関数と同じくメソッドを生やしたような見た目になる。
- 中置記法 - 関数定義にinfixキーワードを付けると、
a.do(b)をa do bと書ける。拡張関数でも使える。要は、好きなクラスに演算子を生やせる。
これらを駆使した結果
buildState(
  "Start",
  {
    setAction(
      buildTransit(
        "TO_ZERO",
        "Zero"),
      { })
  })
的なコードを
"Start" {
  "TO_ZERO" transitTo "Zero" action { }
}
と見事にわかりやすいDSLに落とせましたねと。 なお、このためにString型に拡張関数を生やしていたことについてはツッコミが入っていました。
Android Studio(IntelliJ)のJava→Kotlin変換結果を人手で改善する話
Sansanの辰濱さん(Kenichi Tatsuhama, Sansan | SlideShare)の徳島からのリモート発表。「Java → Kotlin 変換 そのあとに。」
実戦で相当使い込んだんだとよくわかるTips集です。 ここでコメントするよりスライドを見てもらった方が早いですが、
apply使って一時変数を追放するのは気付いていなかった人多そう。
そしてこの発表でも扱っているJavaの変数宣言のNullabilityを機械判定できない話が次の人の発表につながっていきます。
Javaとの相互運用で型がどうなるかって話
むろほしさん(@RyotoMurohoshi)の発表。「Mapped TypeとPlatform Typeの話」
ひとつめのトピックはプラットフォーム型。Kotlinでは型がnullを許容するかどうか明確だけどJavaではそうじゃない。nullを絶対に返さないメソッドもString型のようにnullableな型で返すからKotlin側から扱いにくい。全部String?型扱いにする? それも不要なnullチェックが必要になってノイジー。そこでString!型。Kotlinの外から来たからnullableかnotNullかわかりませんよという型。それがプラットフォーム型。
これはややnull安全から一歩はみ出した言語仕様で、String!型はStringにもString?にも代入できてしまいます。特にStringに代入するときにはプログラマの注意でnullを渡さないようにする必要あり。実行時例外かっとびます。注意と。
もう一つが、int, Integer, ListなんかのJDK上の型がKotlinの型システム上でどう見えるか。型マッピングの仕様です。
KotlinではJavaのListに当たるインターフェースが読み出しのみのListとそれに書き込みを加えたMutableListの2層に切り分けられていて、じゃあJavaのListは相互運用でどう見えるか。Java側でアノテーションを付けることで区別させ、アノテーションなしだと(Mutable)Listというなんかすごい解釈がされるんだそうです。
Androidのビューコンポーネント組み立てをDSL化する話
k-kagurazakaさん(@kkagurazaka)の発表。「Ankoでコンポーネント指向」
XMLで画面を構築するつらみ
- XMLそのものがつらい
- アプリコードと行ったり来たりするのがつらい
- 型安全でないのがつらい
そこでJetBrainsが作っているDSLライブラリ、Ankoどうでしょうという話です。
linearLayout {
  checkBox = checkBox().lparams {
    gravity = Gravity.CENTER_VEDRTICAL
  }
}
というコード、最初のDSLの話を聞いていると何が起こっているかわかりやすいですね。
Kotlin 1.1のbound call references機能の紹介がありました。この機能、Javaでは8ですでに導入されている機能の後追いになる、つまりインスタンスのメソッド参照のことなのですが、Kotlin 1.1のこの機能のちょっと恐ろしいところはJavaでgetter/setterの組として記述されたプロパティをひとつの参照対象とできるところ。執念を感じる。
ラムダ式禁止縛りに関数参照とカリー化で対抗しよう
トリはメインゲストたろうさん(@ngsw_taro)さんの発表。「ラムダ式禁止おじさん」
実際にはもちろん、ラムダ式禁止おじさんに張り合いたいのではなく、ラムダ式と同等の書き方をいろいろできるよという切り口からのKotlinの高階関数機能紹介です。
- 単なる一引数関数なら関数参照で単純に置き換え可能(
::println) - 引数なしメソッドもメソッド参照で単純に置き換え可能(
String::toLowerCase) - 二引数関数はカリー化すればいい。カリー化する仕組みは自作する。どうやって作るかというと関数に対してinvoke拡張関数を生やす(ラムダ式禁止おじさんを完全に殺す黒魔術)。(
(::minus)(5)) - カリー化するにも、先頭でなく右側の引数を固定したい場合はどうする? プレースホルダ付きカリー化だ。そういうinvoke拡張関数を生やしてカリー化すればいい。プレースホルダはEnumで定義する。すると⋯ (
(::minus)(アレ, 3)) - Java8のインスタンスメソッド参照(
"ABC"::toLowerCase)みたいなのをKotlin 1.0でどうやるか(Kotlin 1.1ならできるようになるのは前の人の発表であった通り)。カリー化invokeが定義された状態で、こう。(String::toLowerCase)("ABC") - nullableメソッドコール
?.をするラムダ式はどうする?(引数型->戻り型)型を(引数型?->戻り型?)型に変換するような拡張関数を関数に生やしてしまえ。その拡張関数の名前をnullOkとすると、(String::toLowerCase.nullOk())
そして結論はラムダ式使え。その理由はコードの読みやすさとかそういうのもあるものの、インライン展開というKotlinの利点が殺されてしまうからというのもあります。
懇親会
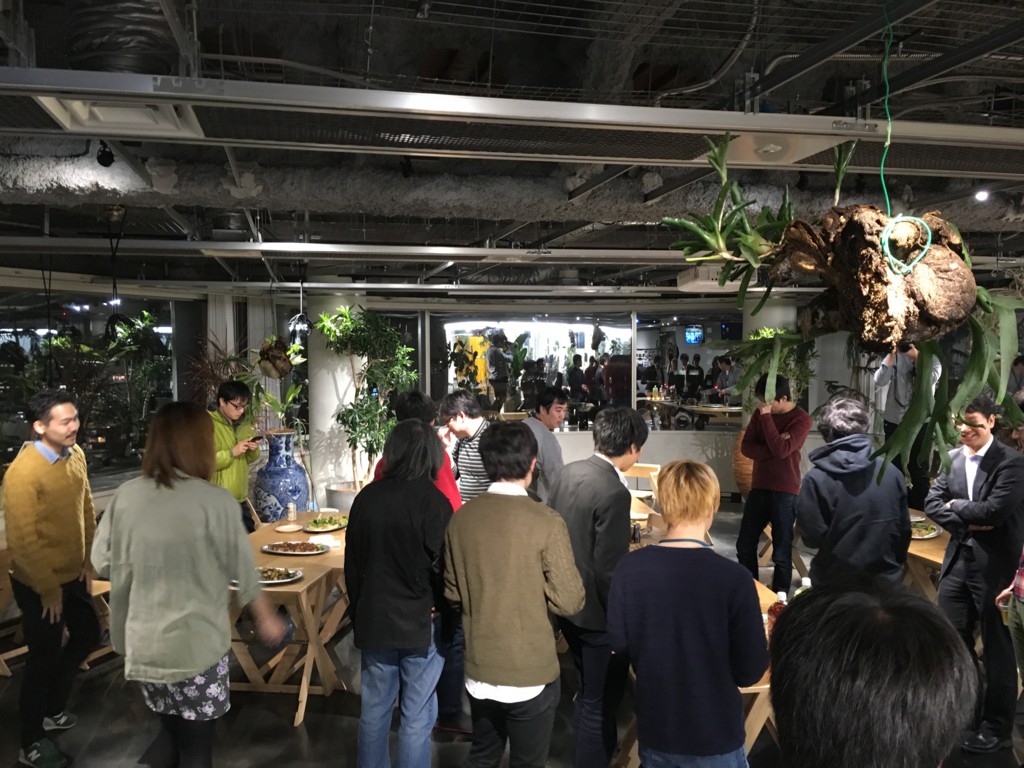 せっかくの懇親会、お二方としかおしゃべりしませんでしたチキンでごめんなさい⋯
お話しした方の話で印象に残ったのが、「JavaからKotlinへの移行は容易だがKotlinからJavaへは簡単に移行できないので、長期間続けるプロダクトに採用しにくい」という意見でした。そういえばAltJSではTypeScriptが猛烈な勢いで普及していますが、これの強みは言語そのものの良さだけでなく「JavaScriptにも容易に戻れる」という安心感はあるよなと思い起こしました。
全体的な所感
まだKotlinが普及初期であること、あとこの勉強会がまだ4回目と回数を重ねていないこともあり、マニアックな方面に偏ってしまわない誰でも理解できる内容の発表ばかりで、それでいて実のある話が聞けとても良いセッションでした。
LT持ち寄りの勉強会は全体としてのテーマというのが決められていないものなのですが、山本さんがDSL構築の話をしたあとにk-kagurazakaさんがその応用となる話をされていたのが見事にはまっていました。辰濱さんとむろほしさんの発表がnullabityでつながっていたのも一体感ありましたし、神の見えざる手を感じましたね。
発表者の皆様、Sansan様、ありがとうございました。
ちょまど問題の算数的解法を改善=14手
昨日の http://cs.hatenablog.jp/entry/2014/06/18/174157 には出題者の名前からちょまど問題という名前が付いたようです。
16手というのは算数的解法で、数学的にはまだまだ先があるのですが、ともかく算数的には16手が最短かと思っていましたが、まだまだ改善の余地がありましたね。14手になります。
解法のアイディア
- まず3回の試行で正解の分布を知る。正解を多く含む順に上位の選択肢2つ(A,Bと名付ける)と下位の選択肢2つが決まる。
- 9回の試行で、問9までについて正解がAかBか下位かがわかる。下位が正解の問題は最大4問。
- 2択問題が最大で4問なら、それらは2回の試行で正解がわかる。
- 問10の答は正解の分布から差し引きでわかる。
3 + 9 + 2 = 14手。
4択10問テストの正解探索回数=最大16回(破られた)
本日twitter上でエンジニアの間で話題になった問題。
4択問題10問のテストを全部埋めて提出すると正解数がわかります。
何回提出すればすべての正解を知ることができますか。
10問すべての正解は、最大16回の試行で知ることができます。
(2014-06-20追記:これは算数の範囲内での答なのですが、算数の範囲内でもさらに改善できました。14手です。 http://cs.hatenablog.jp/entry/2014/06/20/132605 )
PostgreSQLでは識別子に大文字を使ってはいけない
タイトルの通り、PostgreSQLではテーブル名、カラム名など識別子に英大文字を使うべきではありません。
続きを読む